IA en la Empresa
Meta lanza Llama 4: el gigante de código abierto que dinamita la hegemonía de los modelos privativos
11 min
Meta ha liberado Llama 4, su nuevo modelo fundacional de 400.000 millones de parámetros, completamente de código abierto y con razonamiento multimodal nativo. Una declaración de guerra a OpenAI, Anthropic y Google que pone en manos de empresas y desarrolladores un modelo gratuito que iguala —y a menudo supera— a las opciones privativas más caras del mercado.
Ayer, 29 de abril de 2026, la industria de la Inteligencia Artificial sufrió uno de los mayores terremotos de su corta pero intensa historia. Meta ha liberado oficialmente Llama 4, su nuevo modelo fundacional de 400 mil millones de parámetros, completamente de código abierto y con capacidades de razonamiento multimodal nativo. Este lanzamiento no es solo una actualización técnica; es una declaración de guerra comercial a gigantes como OpenAI, Anthropic y Google, poniendo en manos de la comunidad de desarrolladores y empresas un modelo gratuito que, según los primeros benchmarks oficiales, iguala e incluso supera a los modelos privativos más caros del mercado. El movimiento de Mark Zuckerberg promete acelerar la adopción corporativa de la IA al eliminar las barreras de coste y privacidad que hasta ahora frenaban a muchas organizaciones.
El Contexto: la evolución incesante hacia la democratización del poder computacional
Para entender la magnitud de este lanzamiento, debemos retroceder brevemente a los últimos dos años. Cuando Meta lanzó Llama 3 en 2024, el mercado aplaudió la iniciativa, pero los modelos más potentes (aquellos en la frontera de los 400B de parámetros o más) seguían siendo feudos exclusivos de empresas con modelos de negocio basados en el pago por uso (API). En aquel momento, la comunidad open source lograba maravillas mediante la cuantización y el fine-tuning de modelos más pequeños, pero las corporaciones con necesidades complejas seguían cautivas de las suscripciones premium.
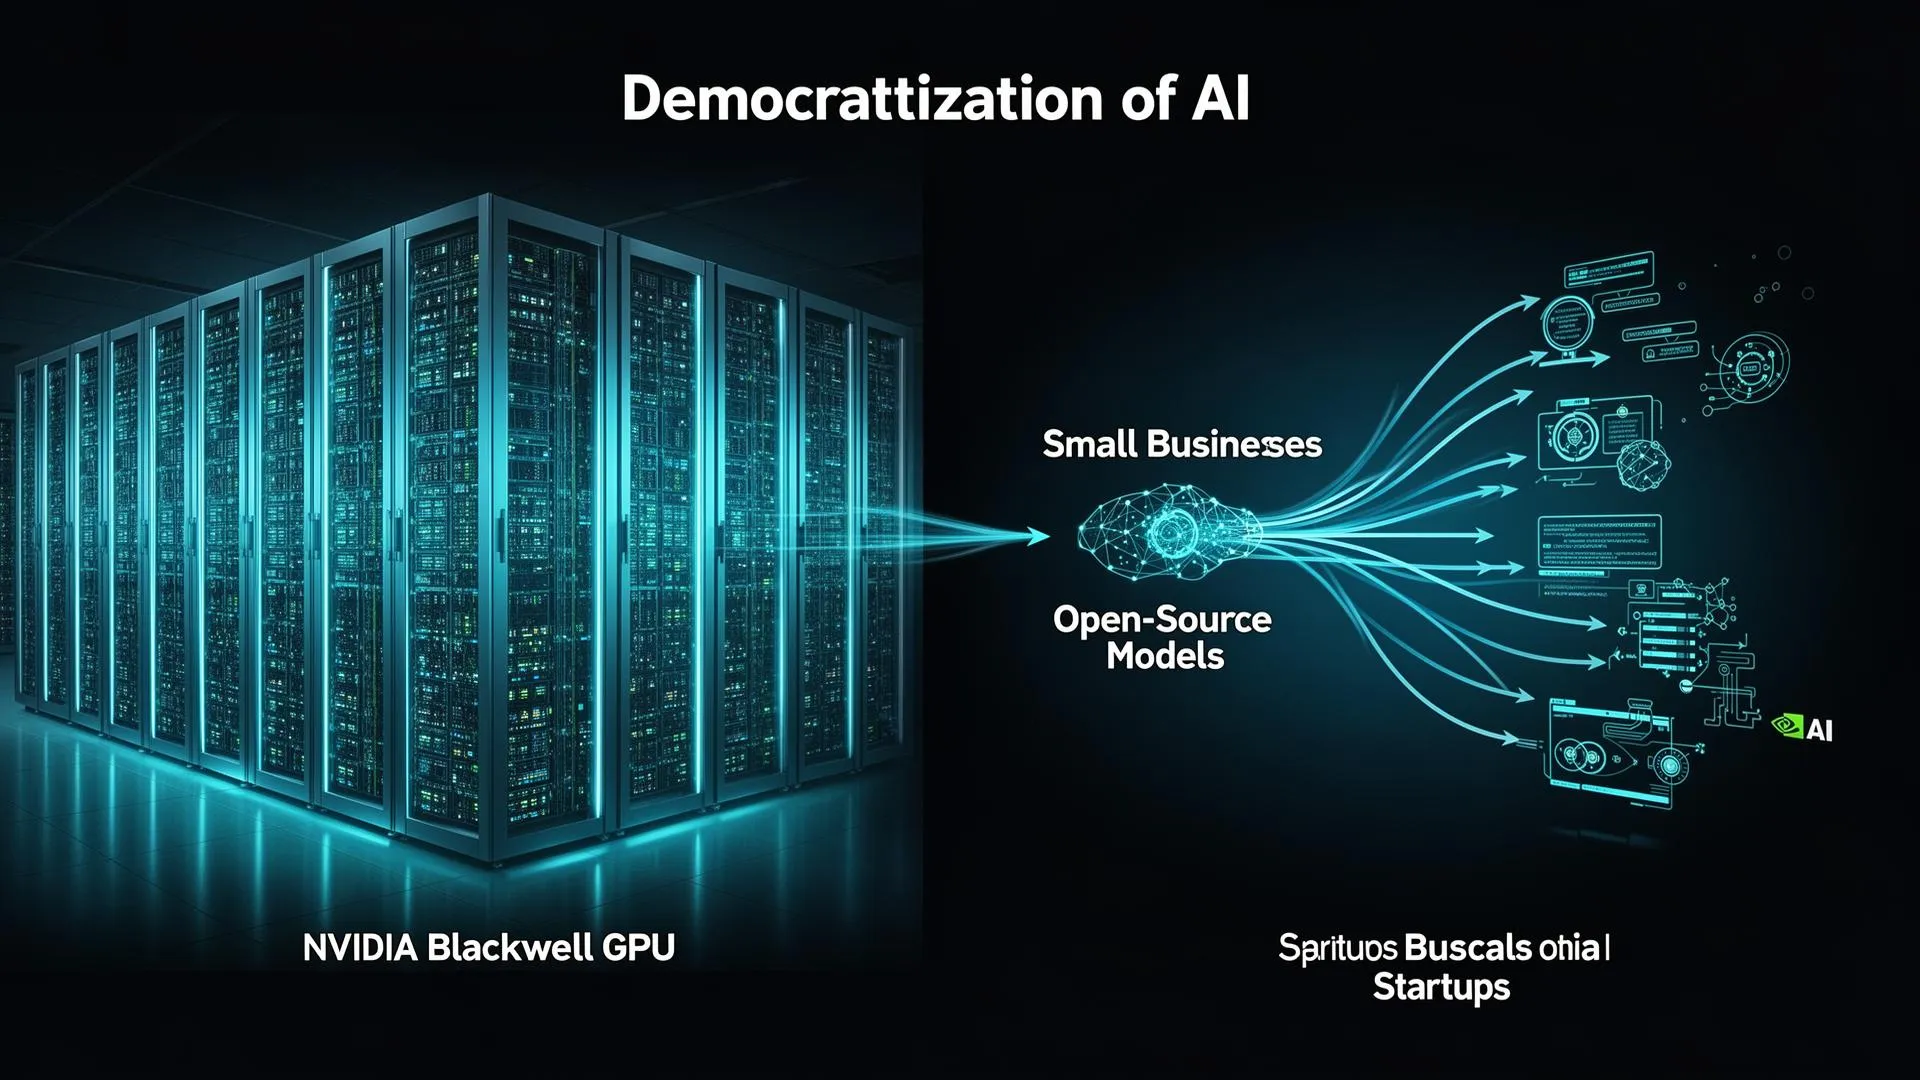
Durante todo 2025, Meta invirtió miles de millones de dólares en la adquisición de clústeres masivos de las nuevas GPUs Blackwell de NVIDIA, creando una infraestructura de entrenamiento sin precedentes. El objetivo no era otro que comoditizar el estrato base de la Inteligencia Artificial. Si el modelo fundacional es gratuito y de código abierto, el valor se desplaza hacia la capa de aplicación y el ecosistema, un terreno donde Meta se siente extraordinariamente cómoda.
Hoy, con Llama 4, esa promesa se ha materializado. Ya no estamos hablando de un modelo "suficientemente bueno" para tareas secundarias. Estamos ante un sistema que ha devorado literalmente los benchmarks más exigentes en matemáticas avanzadas, generación de código complejo y, sobre todo, comprensión de vídeo en tiempo real. La barrera entre lo que puede hacer un modelo de suscripción mensual y un modelo que puedes correr en los servidores locales de tu empresa acaba de desaparecer por completo.
Arquitectura Técnica y Multimodalidad Nativa: las entrañas de la bestia
El secreto detrás del rendimiento de Llama 4 radica en su evolución hacia una arquitectura de Mixture of Experts (MoE) hiper-optimizada. A diferencia de los modelos densos tradicionales donde cada parámetro se activa para cada consulta, Llama 4 utiliza una red de enrutamiento que activa solo a los "expertos" necesarios para resolver un problema específico. Esto significa que, aunque el modelo tiene un tamaño colosal en disco, su inferencia es sorprendentemente rápida y eficiente en términos de memoria RAM y VRAM.
Pero el verdadero salto cuántico de Llama 4 es su multimodalidad nativa. En generaciones anteriores, para que una IA "viera" una imagen o "escuchara" un audio, se requerían modelos separados que traducían esos inputs a texto, perdiendo enormes cantidades de matices. Llama 4, por el contrario, ha sido entrenado desde cero procesando texto, audio, imágenes y vídeo de forma conjunta en el mismo espacio latente. Esto le permite entender la ironía en el tono de voz de un cliente, analizar la microexpresión facial en un vídeo de seguridad, o extraer datos estructurados de un gráfico técnico borroso sin pestañear.
Además, Meta ha introducido una ventana de contexto ampliada a 1 millón de tokens. Esto permite a las empresas introducir el equivalente a 30 manuales técnicos extensos, la base de código completa de una aplicación mediana, o horas de grabaciones de reuniones en un solo prompt, sin sufrir el temido efecto de "pérdida en el medio".
Casos de Uso: cómo transforma el día a día corporativo
1. Programación y Refactorización Autónoma
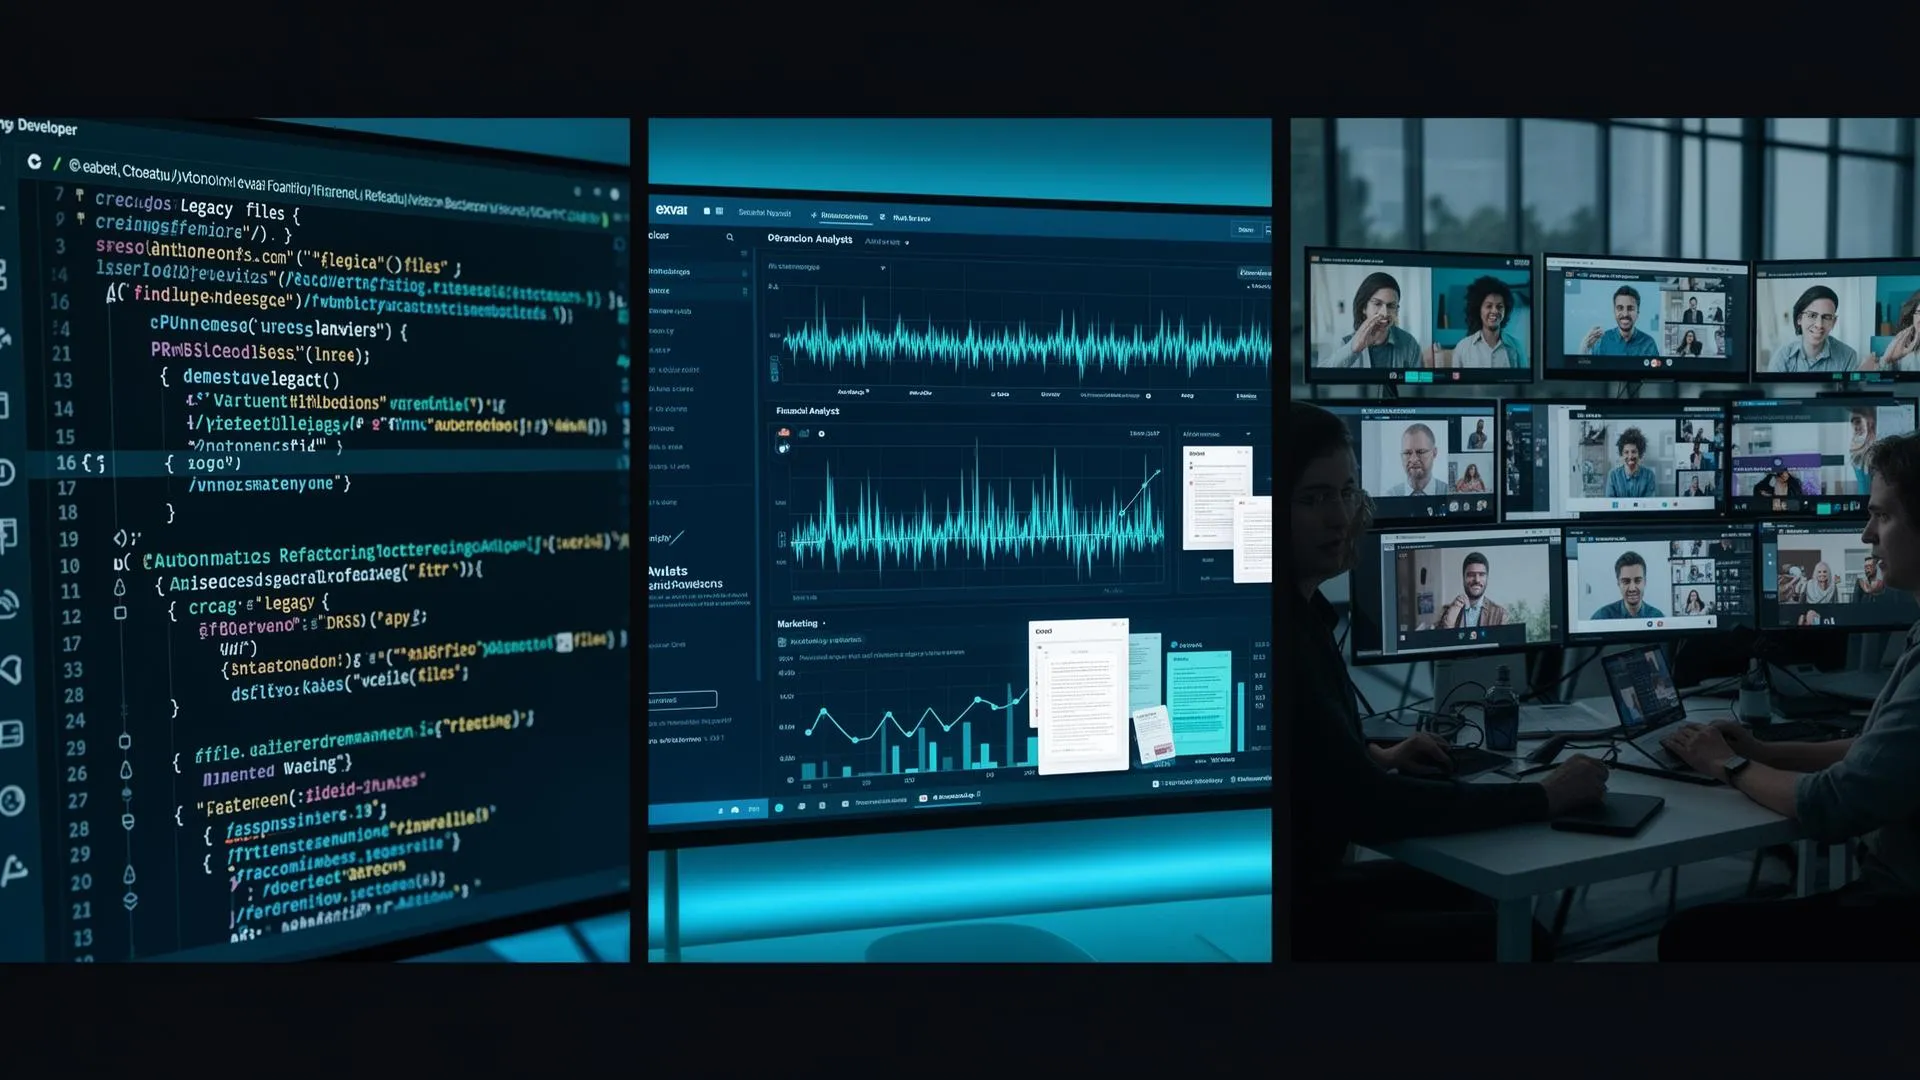
Imagina un equipo de desarrollo lidiando con una base de código heredada (legacy) de hace una década. Con la ventana de contexto masiva de Llama 4, los ingenieros pueden cargar repositorios enteros de forma local. El modelo actúa como un Arquitecto de Software Senior que no solo detecta bugs en tiempo real, sino que es capaz de refactorizar docenas de archivos simultáneamente. Todo esto ocurre dentro de los servidores de la empresa, garantizando que el código propietario jamás viaje a la nube pública, eliminando así el principal riesgo de seguridad que frenaba el uso de IA en sectores bancarios o de defensa.
2. Análisis de Datos Financieros en Tiempo Real
Hasta ahora, un analista financiero pasaba horas leyendo informes de resultados en PDF y escuchando las llamadas de inversores (earnings calls). Gracias a la multimodalidad nativa de Llama 4, una firma de inversión puede inyectar en el modelo la llamada de audio en directo del CEO de una compañía, junto con su histórico financiero en PDF. El modelo es capaz de detectar nerviosismo o evasivas en el tono de voz del directivo y contrastar sus declaraciones con los datos duros en tiempo real, generando un dashboard predictivo de riesgo en segundos.
3. Hiper-personalización Dinámica a Escala
Para un director de marketing global, Llama 4 permite la generación de "gemelos digitales de campaña". Al procesar simultáneamente datos de rendimiento pasados, directrices de marca y el sentimiento actual de las redes sociales, el modelo puede generar de forma autónoma variaciones de vídeos publicitarios donde el tono, el guion y los elementos visuales se ajustan específicamente a la demografía de quien lo visualiza, maximizando el ROI sin necesidad de costosas regrabaciones.
La Perspectiva: Competitividad en el nuevo ecosistema empresarial
Desde IA DiarIA hemos seleccionado la Competitividad como el ángulo clave de este lanzamiento. La liberación de Llama 4 reescribe las reglas del juego para las empresas. Hasta hoy, el dilema corporativo era: ¿Invierto en licencias millonarias de APIs de IA cerradas, asumiendo el riesgo de enviar mis datos sensibles fuera, o me conformo con modelos locales mediocres? Ese dilema ha muerto. Meta acaba de entregar a las empresas la capacidad de tener la inteligencia de un equipo multidisciplinar de expertos corriendo en sus propios centros de datos.
Por otro lado, esto supone una presión asfixiante para el resto de las Big Tech. OpenAI, Google y Anthropic se verán forzados a reducir drásticamente los precios de sus APIs o a lanzar capacidades verdaderamente inalcanzables para justificar su coste. La inteligencia artificial de propósito general se ha convertido oficialmente en una commodity.
La Opinión de IA DiarIA
No es hype, es el cambio de paradigma definitivo. Lo que Meta ha hecho es sacrificar sus ingresos directos por IA para convertirse en el sistema operativo fundacional del futuro. Para los early adopters y profesionales que nos leéis: es el momento de dejar de experimentar exclusivamente en la nube. El diferencial competitivo en los próximos dos años residirá en el talento capaz de orquestar, cuantizar y desplegar modelos de esta magnitud de forma local, adaptándolos a los flujos de trabajo hiper-específicos de cada empresa.
Glosario Técnico Breve
- MoE (Mixture of Experts): Arquitectura donde la red neuronal se divide en sub-redes (expertos). Solo una fracción del modelo se activa para cada consulta, ahorrando recursos.
- Multimodalidad Nativa: Capacidad del modelo para procesar diferentes tipos de datos (texto, audio, imagen) simultáneamente desde su entrenamiento inicial, sin requerir traductores intermediarios.
- Cuantización: Técnica para reducir la precisión matemática de los pesos de un modelo (ej. de 16 bits a 4 bits) para que pueda ejecutarse en hardware menos potente sin perder demasiada calidad.
💬 Llamada a la Comunidad: Con un modelo de esta potencia disponible de forma gratuita, ¿creéis que el modelo de negocio basado en suscripciones API de empresas como OpenAI tiene los días contados, o siempre habrá un mercado premium para modelos cerrados? Os leemos en los comentarios.