Innovación en IA
Microsoft y NVIDIA fulminan la dependencia de la nube: RTX Spark trae los agentes autónomos de forma nativa a Windows
11 min
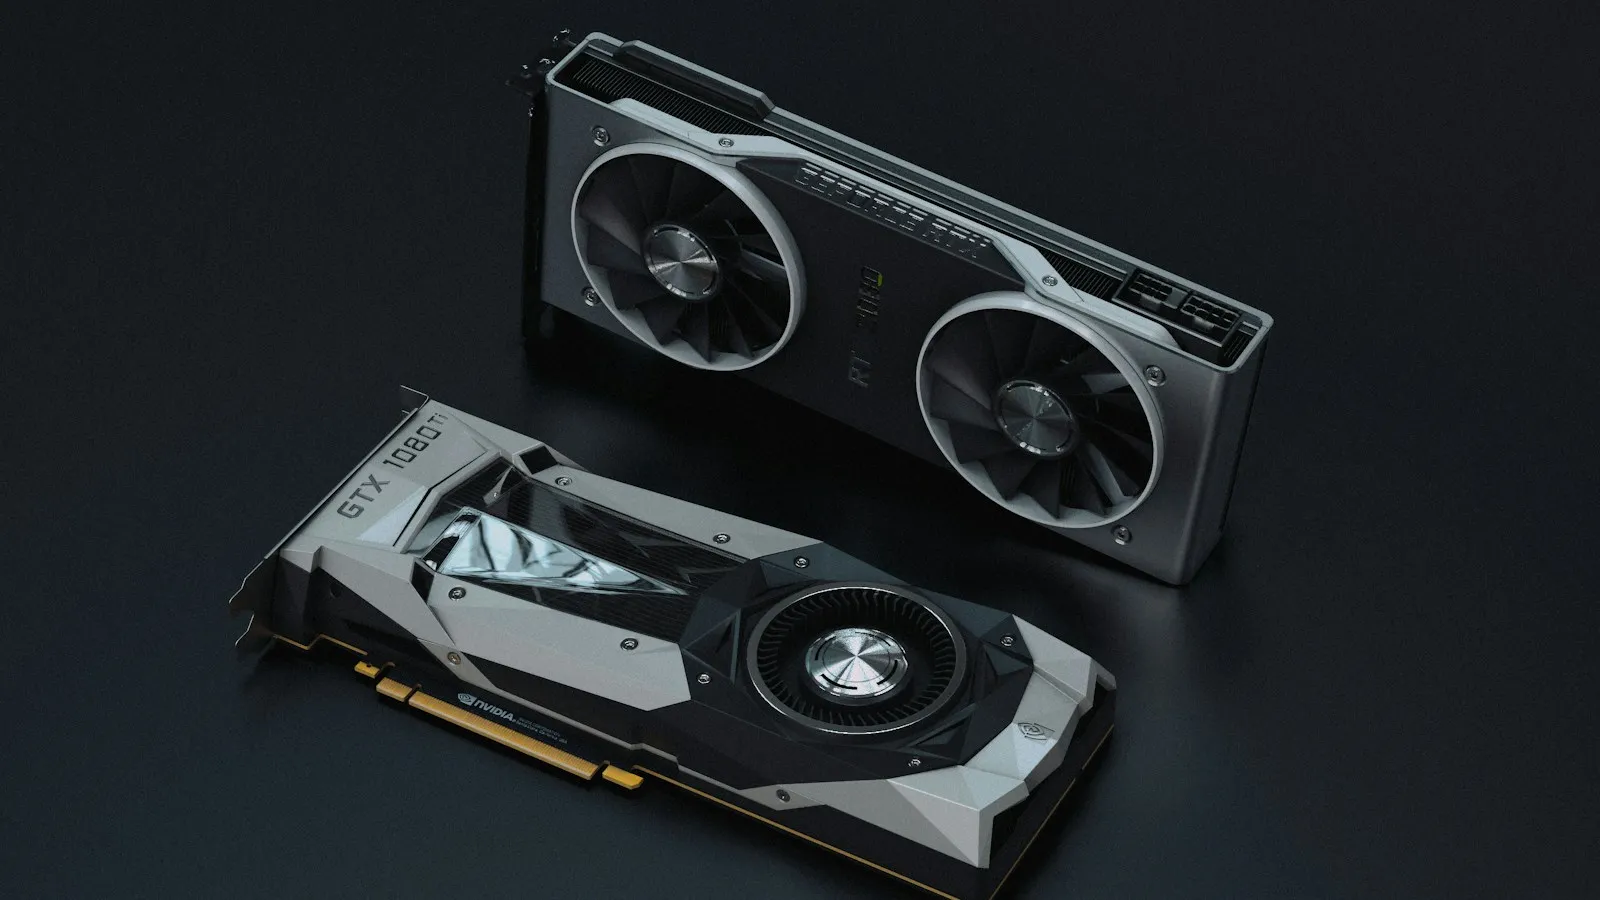
Microsoft y NVIDIA presentan el superchip RTX Spark: 1 petaflop, 128 GB de memoria unificada y capacidad para ejecutar LLMs de 120B parámetros nativamente en Windows. Soberanía del dato, coste marginal cero y fin del 'pago por token' para inferencia profesional.
El 2 de junio de 2026 marca el inicio de una nueva era en la computación personal. Microsoft y NVIDIA han consolidado el lanzamiento de su iniciativa conjunta: ordenadores equipados con el superchip RTX Spark, diseñados específicamente para ejecutar agentes de IA de forma local en Windows. Con 1 petaflop de potencia y hasta 128 GB de memoria unificada, tu PC ahora puede ejecutar modelos de 120.000 millones de parámetros de forma completamente nativa y soberana.
El Contexto: Del cuello de botella en la nube a la soberanía del dato
Durante años, la industria nos convenció de que el futuro de la IA pasaba por inmensos centros de datos. Herramientas como ChatGPT o Claude dependían de una arquitectura centralizada que introdujo cuellos de botella severos: latencia, caídas y un riesgo de privacidad inasumible para muchas corporaciones.
El ecosistema empresarial estaba atrapado: los profesionales necesitaban automatizar con IA, pero los departamentos de TI y Compliance prohibían subir datos sensibles a terceros. Esto frenó la adopción real en banca, sanidad, ámbito legal y defensa. La "Edge AI" era la respuesta, pero las NPU previas colapsaban con cargas agentiformes complejas.
La arquitectura conjunta de Microsoft y NVIDIA rompe este techo de cristal, trasladando el verdadero núcleo de computación neuronal al escritorio del profesional.
Arquitectura Técnica: Un centro de datos en tu escritorio
El RTX Spark es capaz de sostener 1 petaflop continuo en operaciones de IA, una cifra que hace un lustro requería armarios enteros de servidores. Permite ejecutar LLMs de hasta 120B parámetros con ventana de contexto de 1 millón de tokens, sin un solo cable de red.
La clave es la memoria unificada de hasta 128 GB de alta velocidad. CPU, GPU y NPU no copian datos entre bancos separados, eliminando el principal embudo al ejecutar modelos masivos y permitiendo inferencia instantánea sin latencia.
Microsoft aporta "NVIDIA OpenShell", una capa de primitivas de seguridad y ejecución nativa en Windows 11. La IA actúa como un usuario proxy con permisos granulares: puede leer archivos, organizar directorios y ejecutar comandos, todo confinado en un sandbox criptográfico que impide que datos privados salgan al exterior.
Casos de Uso Prácticos: Transformando el día a día sin conexión
Marketing y Growth
Un equipo de growth puede generar y editar vídeo publicitario en 4K con ComfyUI + DLSS 4.5 directamente en local. Los agentes rastrean discos, cruzan brand guidelines con métricas y ensamblan decenas de variantes optimizadas sin subir nada a la nube.
Programación y DevOps
Con 1 millón de tokens locales, un desarrollador puede cargar el repositorio completo, documentación histórica y 3 años de logs en memoria. El agente audita el código offline, propone refactors masivos y compila tests al instante. Ideal para entornos air-gapped o estrictos NDAs.
Análisis de Datos con privacidad total
Un analista financiero procesa 10M de transacciones bancarias para detectar fraude sin que un solo bit abandone el disco duro. Cumplimiento GDPR/HIPAA al 100% garantizado por arquitectura.
La Perspectiva: El coste marginal cero
Estamos ante el fin del modelo "pago por token". Al trasladar el cómputo al hardware local (CAPEX en lugar de OPEX), el coste marginal de ejecutar un agente millones de veces es literalmente cero, limitado solo por el consumo eléctrico. Esto invita a una experimentación corporativa mucho más audaz.
La eliminación de la latencia de red transforma la simbiosis humano-máquina. La interacción se vuelve tan inmediata como abrir una carpeta local. Combinado con acceso a nivel de sistema operativo, el modelo se convierte en una extensión cognitiva del trabajador.
La Opinión de IA DiarIA
Esto no es una actualización de hardware; es el punto de inflexión donde la IA se emancipa de la nube. Si tu empresa planeaba renovar su flota de ordenadores este trimestre, paralizad la compra: el estándar ha cambiado de la noche a la mañana.
Glosario Técnico
- Edge AI: Procesamiento de IA a nivel local, sin depender de centros de datos externos.
- Memoria Unificada: Arquitectura donde CPU, GPU y NPU comparten un único pool de RAM de alta velocidad.
- Petaflop: Mil billones de operaciones de coma flotante por segundo.
- LLM: Modelo fundacional de lenguaje entrenado con cantidades masivas de información.
Llamada a la Comunidad
¿Cuál es el primer conjunto de datos confidenciales de tu empresa que le darías a un agente local para analizar? Os leemos en los comentarios.