Innovación en IA
Meta libera Llama 4: El gigante Open Source rompe el mercado y amenaza la hegemonía de las APIs privativas
14
Mark Zuckerberg anuncia Llama 4, un modelo de más de 1 billón de parámetros con arquitectura Mixture of Experts, multimodalidad nativa y ventana de contexto de 1 millón de tokens, gratuito para uso comercial. El open source iguala por primera vez a los modelos propietarios de frontera.
Hoy, 26 de marzo de 2026, marca un antes y un después en la industria de la Inteligencia Artificial. Mark Zuckerberg ha anunciado el despliegue global de Llama 4, un modelo fundacional de más de 1 billón de parámetros que, por primera vez en la historia, iguala y en métricas clave supera a los modelos propietarios de frontera. Con un enfoque radical en la multimodalidad nativa y capacidades de agente autónomo, este lanzamiento gratuito para uso comercial redefine las reglas del juego para desarrolladores, corporaciones y startups.
El Contexto: De la experimentación a la madurez corporativa
Para entender la magnitud tectónica del lanzamiento de Llama 4, debemos retroceder a la evolución frenética que hemos vivido en el ecosistema desde 2023. Los primeros modelos de la familia Llama democratizaron el acceso a la tecnología generativa, permitiendo que la comunidad académica y los desarrolladores independientes pudieran trastear con redes neuronales en sus propios equipos. Sin embargo, aquellos modelos todavía requerían un esfuerzo titánico de fine-tuning para ser útiles en entornos empresariales complejos.
El salto exponencial que supuso Llama 3 en 2024 nos demostró que la filosofía del código abierto podía empezar a mirar de tú a tú a las soluciones de pago en tareas conversacionales y de asistencia general. No obstante, seguía existiendo una brecha técnica palpable, especialmente cuando hablábamos de ventanas de contexto masivas y la integración fluida de visión y voz sin latencia.
Llegados a este primer trimestre de 2026, el mercado ha madurado de forma agresiva. Las empresas ya no buscan simplemente un chatbot; exigen ecosistemas de agentes autónomos capaces de razonar, planificar, ejecutar código de forma segura y tomar decisiones basándose en repositorios de datos masivos no estructurados. Meta ha comprendido que la batalla no se libra en la venta de suscripciones mensuales, sino en convertirse en la infraestructura base sobre la que se construya el software de la próxima década.
La estrategia de la compañía no responde a un altruismo corporativo, sino a una jugada maestra de comoditización. Al regalar el modelo fundacional más avanzado del planeta, Meta devalúa instantáneamente el núcleo del modelo de negocio de sus competidores directos, asegurándose de que su arquitectura sea el estándar de facto.
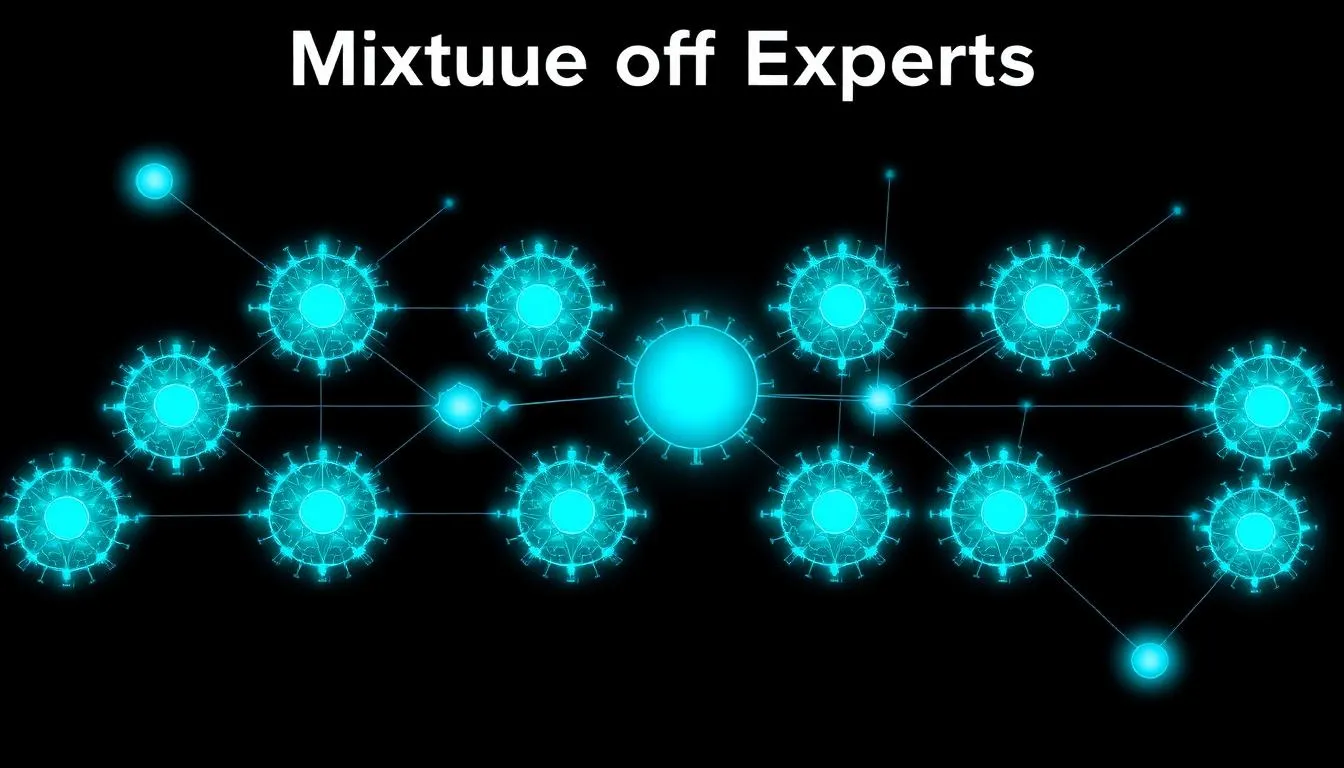
Arquitectura Técnica: La era del 'Mixture of Experts' masivo y la multimodalidad nativa
El verdadero hito tecnológico detrás de Llama 4 no radica únicamente en su abrumador tamaño bruto, sino en su sofisticada arquitectura Mixture of Experts (MoE) dinámica. A diferencia de las redes neuronales densas tradicionales donde todos los parámetros se activan para cada consulta, Llama 4 enruta las peticiones del usuario hacia subredes altamente especializadas. Esto reduce drásticamente el coste computacional de inferencia, permitiendo que un modelo de más de un billón de parámetros pueda correr en clústeres empresariales estándar.
En segundo lugar, la ventana de contexto ha sido ampliada y estabilizada a 1 millón de tokens con una tasa de recuperación perfecta. Las pruebas de "aguja en el pajar" (needle-in-a-haystack) publicadas hoy demuestran un 100% de precisión al extraer información oculta en documentos del tamaño de la saga completa de Harry Potter.
Además, estamos ante el primer gran lanzamiento open-source que es multimodal desde sus cimientos. No se trata de un modelo de lenguaje de texto al que se le han "pegado" módulos externos de visión. Llama 4 procesa píxeles, ondas sonoras y tokens de texto en un mismo espacio de representación latente, reduciendo la latencia a milisegundos.
Finalmente, el equipo de Meta ha puesto un foco obsesivo en la eficiencia y la seguridad. Llama 4 se distribuye con herramientas de cuantización extremas, permitiendo comprimir sus versiones más pequeñas para que se ejecuten directamente en estaciones de trabajo y portátiles de gama alta. Todo ello envuelto en el nuevo framework Llama Guard 3, un sistema de moderación que mitiga las inyecciones de prompts y previene la ejecución de código malicioso.
Casos de Uso Prácticos: Transformando el día a día corporativo
El despliegue local de un modelo de esta envergadura abre un abanico de posibilidades operativas que hasta ayer requerían enviar información confidencial a servidores de terceros.
1. Revolución en Marketing: Personalización a escala hiperrealista. Un departamento de marketing puede instalar el modelo en un servidor local aislado (on-premise) y alimentarlo con el archivo histórico completo de la compañía: manuales de marca, vídeos de campañas pasadas, paletas de colores y bases de datos de CRM. El modelo puede analizar un briefing en texto, revisar el stock disponible en tiempo real y generar variaciones de campañas publicitarias que combinan copywriting persuasivo con bocetos visuales adaptados a la identidad corporativa, sin vulnerar las normativas de protección de datos como el RGPD.
2. Programación y Desarrollo: De asistente a ingeniero de software autónomo. Las capacidades agénticas de Llama 4 le permiten operar como un miembro más del equipo de ingeniería. Un CTO puede asignar a Llama 4 un ticket complejo de GitHub; el modelo clonará el repositorio, leerá la documentación entera, escribirá el código necesario, generará los tests unitarios, ejecutará pruebas en un sandbox y, si detecta un error, lo iterará y corregirá antes de enviar la Pull Request final para revisión humana.
3. Análisis de Datos: El científico de datos cuántico en local. Gracias a la enorme ventana de contexto y a su capacidad para escribir y ejecutar scripts en Python de forma autónoma, un analista puede darle a Llama 4 acceso directo a la base de datos SQL de la empresa de forma local. El profesional solo necesita hacer preguntas en lenguaje natural y Llama 4 escribe la consulta, extrae los datos, los procesa y devuelve un informe detallado con gráficos dinámicos, sin que un solo byte haya abandonado el edificio de la empresa.
La Perspectiva: El pulso definitivo entre lo abierto y lo cerrado
Si observamos este lanzamiento bajo el prisma puramente estratégico, el terremoto que hoy sacude a los grandes actores de Silicon Valley es innegable. Durante años, empresas pioneras han justificado sus valoraciones estratosféricas y sus costosos planes de suscripción argumentando que el entrenamiento de modelos de frontera requería un capital intensivo exclusivo para muy pocos.
El movimiento de Meta pulveriza ese modelo de negocio tradicional. Al ofrecer de forma gratuita un rendimiento equivalente o superior al de las opciones de pago más punteras del mercado, las startups, las corporaciones multinacionales y los gobiernos tienen ahora un incentivo financiero enorme para internalizar su infraestructura de IA.
Este escenario acelera radicalmente la innovación en la capa de aplicaciones de software. Si el "cerebro" (el LLM) se convierte en una commodity accesible para todos, la ventaja competitiva para las empresas SaaS deja de ser la potencia de la IA subyacente. La verdadera diferenciación se traslada ahora al diseño de la interfaz, a la experiencia del usuario (UX), a los flujos de trabajo específicos de cada nicho y a la integración con herramientas legacy.
Sin embargo, esta democratización masiva también plantea un desafío directo a los proveedores de infraestructura en la nube. AWS, Google Cloud y Microsoft Azure tendrán que pivotar rápidamente: sus ingresos ya no provendrán tanto de revender acceso a modelos privativos, sino de ofrecer los clústeres de computación y entornos seguros más eficientes para alojar versiones de Llama 4. El tablero ha cambiado para siempre.
"La llegada de Llama 4 representa el clavo definitivo en el ataúd del modelo 'LLM as a Service' como negocio exclusivo y monopólico. Cualquier CTO que no esté evaluando cómo migrar sus flujos más críticos a infraestructuras locales con Llama 4, está perdiendo dinero."
Glosario Técnico
- Mixture of Experts (MoE): Arquitectura de red neuronal donde diferentes partes del modelo (los "expertos") se especializan en distintos tipos de tareas. Solo se activan los necesarios para cada consulta, ahorrando recursos computacionales.
- Multimodalidad Nativa: Capacidad de una IA para comprender, procesar y generar texto, imágenes y audio desde su diseño original, sin depender de módulos externos interconectados a posteriori.
- Cuantización: Proceso técnico para reducir la precisión matemática de los pesos de un modelo para que ocupe mucha menos memoria RAM y pueda funcionar en hardware modesto sin perder demasiada inteligencia.
- Ventana de Contexto: La cantidad de información (medida en tokens) que un modelo de IA puede "recordar" y procesar simultáneamente en una sola interacción o consulta.
💬 Llamada a la Comunidad
Con la disponibilidad de este modelo de grado empresarial y gratuito para operar en vuestros propios servidores, nos surge una gran duda: ¿Estáis listos en vuestras empresas para abandonar las APIs privativas y asumir el reto del alojamiento propio, o sigue compensando pagar por la comodidad de la nube? Dejadnos vuestra estrategia en los comentarios.